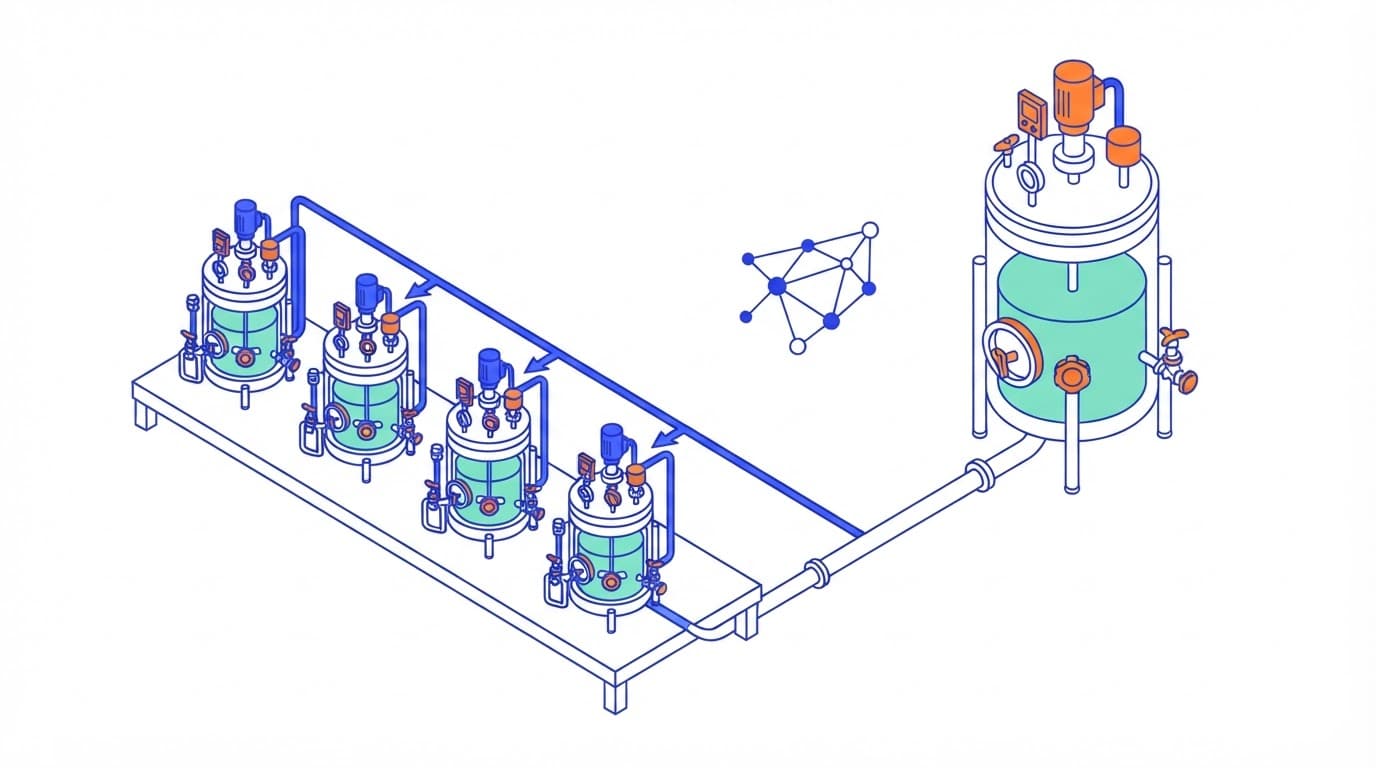
Según los autores, las decisiones de escalado siguen dependiendo en gran medida de la experiencia empírica, porque obtener datos a varias escalas es caro y el conocimiento mecanístico suele ser incompleto. Investigadores de The University of Manchester y Xiamen University publicaron el 21 de septiembre de 2026 en Biotechnology and Bioengineering una alternativa que aprovecha mejor los datos: construir un modelo híbrido con pocos datos de laboratorio y adaptarlo después mediante transfer learning, usando solo información de planta piloto, para predecir la escala industrial.
Esta nota se basa únicamente en el resumen. El texto completo es de acceso abierto con la licencia del editor, pero no pudimos descargarlo desde nuestros servidores, así que todo lo que sigue procede del resumen, y señalamos dónde no dice nada.
Qué dice el resumen
- El problema. Predecir con precisión el escalado se considera clave para implantar sistemas de biofabricación nuevos y sostenibles, y resulta difícil porque los datos multiescala son caros y el conocimiento mecanístico suele ser incompleto. Por eso las decisiones de escalado dependen tanto de la experiencia empírica.
- La estrategia. Se combina el modelado híbrido con transfer learning. El modelo se construye con pocos datos de laboratorio y luego se adapta, solo con información de planta piloto, para predecir a escala industrial.
- La condición de prueba. Los autores consideran una innovación clave haber evaluado el método expresamente en escenarios con pocos datos, porque así reflejan las limitaciones reales del desarrollo industrial.
- El resultado. En un caso real de fermentación con levadura, el marco dio predicciones dinámicas a escala industrial con un error porcentual absoluto medio del 23,2 %.
- La lección de diseño. El grado de «grisura» del modelo híbrido influyó de forma decisiva en su precisión predictiva y en la viabilidad del transfer learning con escasez de datos. El nivel óptimo de grisura cuando faltan datos no es el mismo que cuando abundan.
Los autores presentan estos resultados como la primera guía sobre cómo usar el modelado híbrido y el transfer learning para construir gemelos digitales escalables cuando los datos son limitados.
Lo que el resumen no dice
El resumen no identifica la especie de levadura ni el producto. No da los volúmenes de trabajo de los equipos de laboratorio, piloto e industrial, ni el número de lotes a cada escala, ni la lista de variables predichas. Tampoco indica qué grado de grisura funcionó mejor; solo que el mejor nivel con escasez de datos no coincide con el óptimo cuando hay datos abundantes. Y no explica cómo se reparte el error del 23,2 % en el tiempo ni entre variables. Cualquiera de estos puntos cambiaría hasta qué punto el resultado se puede trasladar a otro proceso, y para conocerlos hace falta el artículo completo.
Por qué lo interesante es el plan de datos
En el marco propuesto, la escala industrial es el objetivo de la predicción, mientras que la etapa de adaptación solo usa información de planta piloto.
El segundo mensaje tiene que ver con la estructura del modelo: el grado de grisura óptimo con muchos datos no lo es cuando escasean. Para un equipo que fija una vez la estructura de su modelo híbrido y la reutiliza, la pregunta pendiente es si esa elección se hizo con el volumen de datos del que realmente va a disponer.