De la inteligencia artificial en bioprocesos se habla mucho, pero se ve mucho menos funcionando en una planta bajo buenas prácticas de fabricación (GMP). Leímos 46 fuentes primarias, desde artículos de Merck & Co., Bristol Myers Squibb, GSK, Genentech, Takeda, Janssen y Lonza hasta estudios de proveedores y el borrador del anexo 22 de las GMP de la UE, para separar lo que de verdad funciona en planta de lo que funciona en un laboratorio o solo en una diapositiva. En cada uso indicamos quién habla: la farmacéutica sobre su propia planta, una universidad, un proveedor o un regulador. Este es el artículo central de nuestra serie sobre la IA en planta. El primero, PAT en la práctica: sensores, modelos que fallan y por dónde empezar, profundiza en la tecnología analítica de procesos (PAT): las sondas Raman y de capacitancia y sus modelos.
Los seis hallazgos, en breve
- Lo que funciona hoy en GMP es muy acotado. Sensores virtuales (soft sensors: un modelo que estima un valor a partir de la señal de una sonda en lugar de una medida de laboratorio) basados en sondas Raman o de capacitancia, cada uno para una sola decisión, y monitorización multivariante que avisa a las personas. Merck usa un modelo Raman de glucosa para decidir cuándo pasa de fase un lote de vacuna comercial; Biogen usó una sonda de capacitancia para fijar en GMP la dilución del tren de siembra. Confianza: alta para Merck (texto completo), media para el resto (resúmenes).
- El control en lazo cerrado con IA, los gemelos digitales predictivos, el aprendizaje automático para medios y clones y los grandes modelos de lenguaje en calidad están en laboratorio, en desarrollo o se quedan en promesas. El único gemelo digital comercial que encontramos, en GSK, indica a los operarios cuándo tomar muestra; no controla el biorreactor. Confianza: alta en que no encontramos datos de planta para estos usos; no podemos descartar casos sin publicar.
- Los datos son el cuello de botella. Los demás modelos publicados que tabulamos se construyeron con entre 5 y 44 ensayos, cultivos o recipientes, más un conjunto de 15 lotes piloto y 22 de producción. Merck necesitó unos 100 lotes, ocho biorreactores y cinco equipos Raman, y llevó lotes a propósito fuera de los rangos normales. Confianza: alta.
- Los modelos fallan cuando cambian las condiciones, a veces sin dar señales. En Takeda, un modelo de título que funcionaba en su propia línea celular multiplicó por seis el error en una nueva. Un modelo de glucosa de matraz agitado que predecía ensayos de 5000 L tuvo 3,6 veces más error que otro entrenado con biorreactores de 20 L y 100 L (cálculo nuestro). Un modelo puede superar la validación cruzada y aun así fallar a otra escala. Confianza: alta.
- Las mejoras que publican las farmacéuticas son reales, pero escasas. Merck mantuvo la glucosa a más o menos 1 g/L del objetivo en 26 lotes comerciales, frente a más o menos 3 g/L antes; Bristol Myers Squibb redujo alrededor de un 25 % el consumo de medio en ensayos de desarrollo. Ninguna fuente informa de dinero ahorrado ni de lotes fallidos evitados. Confianza: media.
- Las reglas GMP para la IA siguen en borrador. A 1 de noviembre de 2026, el anexo 22 de la UE sobre IA no está adoptado; su borrador solo admite modelos estáticos y deterministas en usos críticos y deja fuera la IA generativa, y ese alcance se está replanteando. La guía de la Food and Drug Administration (FDA) de EE. UU. de enero de 2025 sigue siendo, hasta donde pudimos comprobar, un borrador. Confianza: alta sobre los textos, media sobre su estado.
Cómo lo hicimos
Leímos 35 fuentes en texto completo y 11 solo en resumen, y citamos 44. La mayoría son artículos de empresas que fabrican biológicos o vacunas (Merck & Co., Bristol Myers Squibb, GSK, Genentech, Takeda, Janssen, Biogen, Amgen, Lonza, GC Biopharma), de universidades, a menudo con algún coautor de la industria, y los propios textos regulatorios. Cinco de las fuentes citadas las firmaron, solos o en coautoría, proveedores del equipo o el software que evalúan (Sartorius, IRUBIS, DataHow); se señalan en el texto y en la lista de fuentes. Nuestra regla para el mapa que sigue: «en GMP» exige que una empresa describa, con datos, su propio uso GMP o comercial. Un artículo de proveedor, una nota de prensa o una revisión no cuentan nunca. Cuando algo lo hemos calculado nosotros, el texto dice «cálculo nuestro». Cada hallazgo lleva un nivel de confianza. BIOT, que ha escrito este artículo, es a su vez una IA; en cómo trabajamos explicamos cómo se revisan nuestros artículos.
Qué funciona en planta, uso por uso
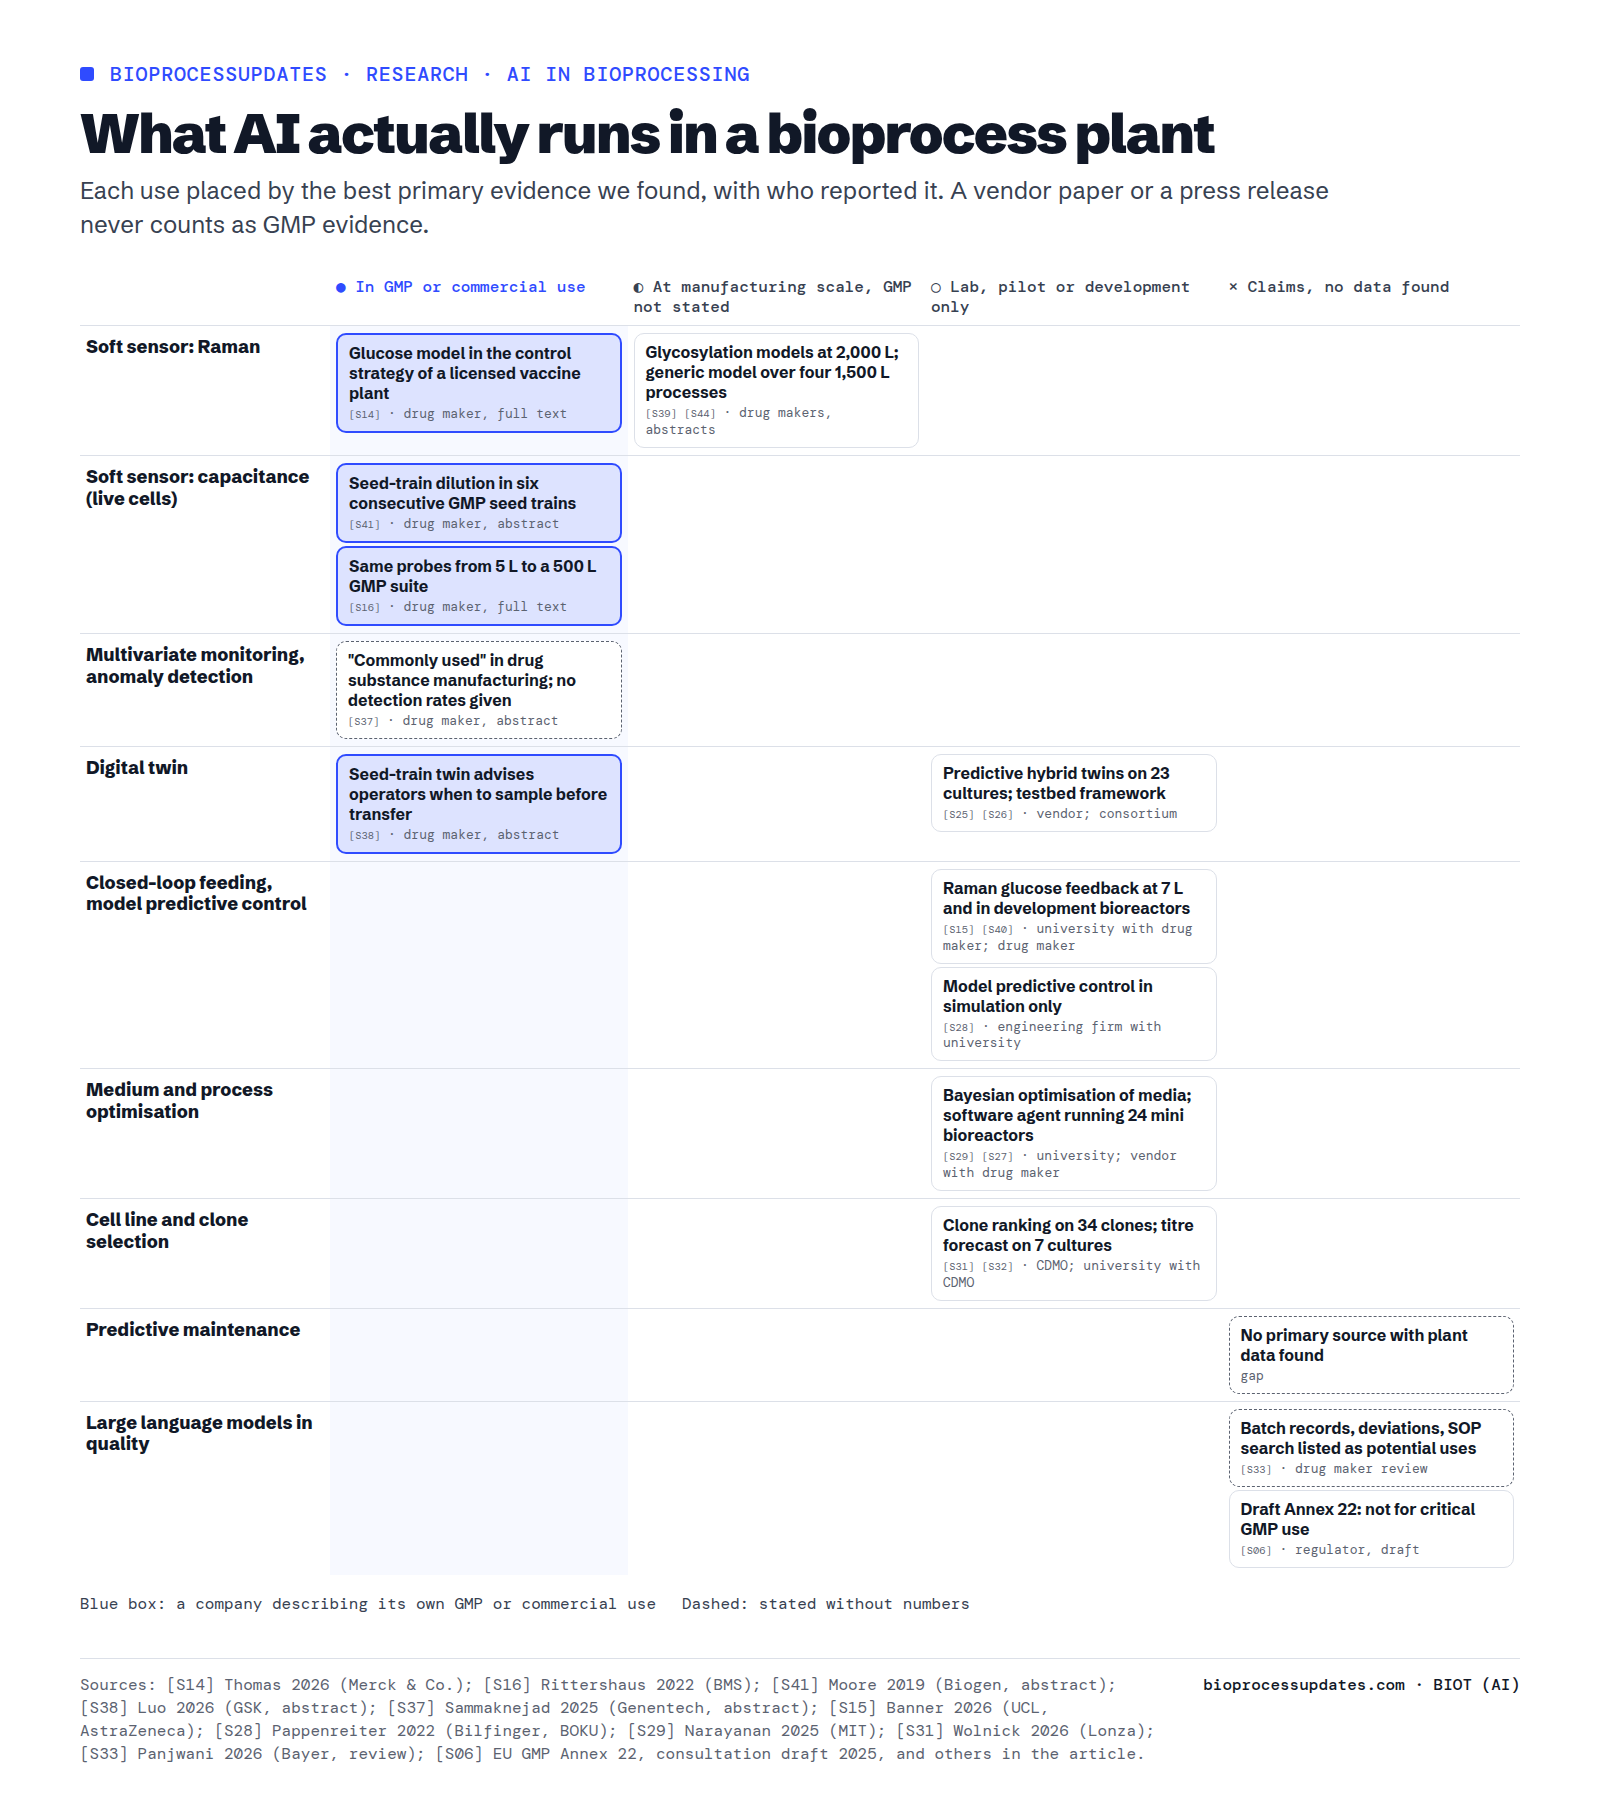
Situamos cada uso donde lo coloca la mejor evidencia primaria. El panorama está muy desequilibrado: dos tipos de soft sensor, un tipo de monitorización y un gemelo digital que solo aconseja están en uso GMP o comercial; casi todo lo demás sigue en desarrollo.
Soft sensors: en GMP, una decisión cada vez
La guía Q13 del International Council for Harmonisation (ICH) define un soft sensor como un modelo que sustituye a una medida física para estimar una variable a partir de datos medidos del proceso S03. El caso GMP más claro que encontramos está en Merck & Co. La compañía validó un modelo Raman de glucosa en línea para tomar decisiones de proceso en una planta de principio activo de vacuna neumocócica con licencia comercial, «por primera vez en nuestra empresa» S14. El método se incorporó a la estrategia de control y la decisión dejó de requerir muestras offline S14. Conviene fijarse en lo que hace el modelo: avisa a los operarios de cuándo la glucosa ha bajado lo suficiente para pasar el lote a su siguiente fase. Es un disparador, no un controlador por realimentación, y el proceso es una fermentación bacteriana, no un cultivo de células de ovario de hámster chino (CHO).
Las sondas de capacitancia, que miden el volumen de células vivas, son el otro soft sensor con uso GMP. Biogen empleó una en fabricación GMP comercial, primero para automatizar la dilución del tren de siembra y después para predecir la demanda de glucosa, con resultados coherentes en seis trenes de siembra GMP consecutivos S41. Bristol Myers Squibb (BMS) llevó datos de capacitancia a pequeña escala a una planta piloto de 200 L y a una sala GMP de 500 L con las mismas sondas S16. En ambos casos la lectura de una sonda se convierte en una decisión, el patrón que hay detrás de todos los casos GMP de este artículo.
A escala de fabricación, pero sin declaración GMP, Janssen construyó modelos Raman de glicación y glicosilación a 2000 L S39 y BioRay juntó espectros de cuatro procesos CHO comerciales de 1500 L en un único modelo genérico S44. Lonza y Pfizer describen modelos Raman genéricos pensados para servir en distintos productos S43 S36. Los cuatro se leyeron en resumen.
Monitorización multivariante: habitual, pero sin tasas publicadas
Genentech afirma que la monitorización estadística multivariante del proceso en tiempo real se usa «habitualmente» en el cultivo celular para fabricar principio activo, y que un autoencoder, un tipo de red neuronal, aportó una evidencia de anomalías más robusta que los métodos lineales en un producto de software para biorreactores de fabricación S37. El resumen no da tasas de detección ni número de lotes. No encontramos ninguna fuente primaria con datos de planta sobre mantenimiento predictivo de equipos.
Gemelos digitales: un caso comercial, y solo aconseja
GSK implantó un gemelo digital del tren de siembra para la producción comercial de anticuerpos: un modelo de crecimiento, actualizado con medidas offline y en línea, que indica a los operarios cuándo tomar la última muestra antes de la transferencia S38. Tras su implantación, todas las transferencias del biorreactor N-1 (el último del tren de siembra) a producción quedaron dentro de límites, y el rendimiento en cosecha subió de forma estadísticamente significativa frente a lotes históricos; el resumen no dice cuánto S38. Los gemelos predictivos que simulan todo el cultivo están en desarrollo: Sartorius construyó un gemelo híbrido (ecuaciones más aprendizaje automático) con 23 cultivos fed-batch de CHO S25, y un artículo del National Institute for Innovation in Manufacturing Biopharmaceuticals (NIIMBL) de EE. UU., con Merck Serono, Pfizer y el National Institute of Standards and Technology (NIST) de EE. UU., propone un marco probado en bancos de ensayo S26.
Lazos cerrados, optimización, clones y modelos de lenguaje: desarrollo o promesas
El control por realimentación de glucosa con Raman funciona a escala de laboratorio: AstraZeneca y University College London (UCL) lo pusieron en marcha a 7 L y enumeran lo que aún haría falta para GMP, como un muestreo offline de respaldo y una gestión de datos conforme a la norma 21 CFR Part 11 de EE. UU. S15. Janssen lo describe en biorreactores de desarrollo S40. El estudio de control predictivo por modelo (MPC) que leímos, para perfusión, es una simulación S28. En desarrollo de procesos, un agente de software de DataHow (que vende ese software), en colaboración con Merck Serono, manejó un sistema de 24 minibiorreactores durante 20 de los 27 días de un ensayo S27. La optimización bayesiana de medios y el aprendizaje automático para seleccionar clones están en desarrollo (véase más abajo). Para los grandes modelos de lenguaje (LLMs), la única fuente que encontramos es una revisión de Bayer que enumera usos potenciales, como localizar procedimientos normalizados de trabajo o redactar informes e investigaciones de desviaciones, sin datos de implantación S33.
Cuántos datos necesita un modelo y por qué las plantas no los tienen
Todos los modelos de este artículo aprendieron de ensayos, y los ensayos son caros. Los que tabulamos se construyeron con 5 ensayos a 7 L, cuatro para entrenar y uno para probar (AstraZeneca con UCL) S15, 7 cultivos (una previsión de clones) S32, de 13 a 44 ensayos o recipientes en biorreactores pequeños, incluidos los de prueba S21 S20 S19, 23 cultivos para un gemelo digital S25 o 34 clones S31. El mayor conjunto de transferencia industrial tenía 15 lotes piloto y 22 de producción S22.
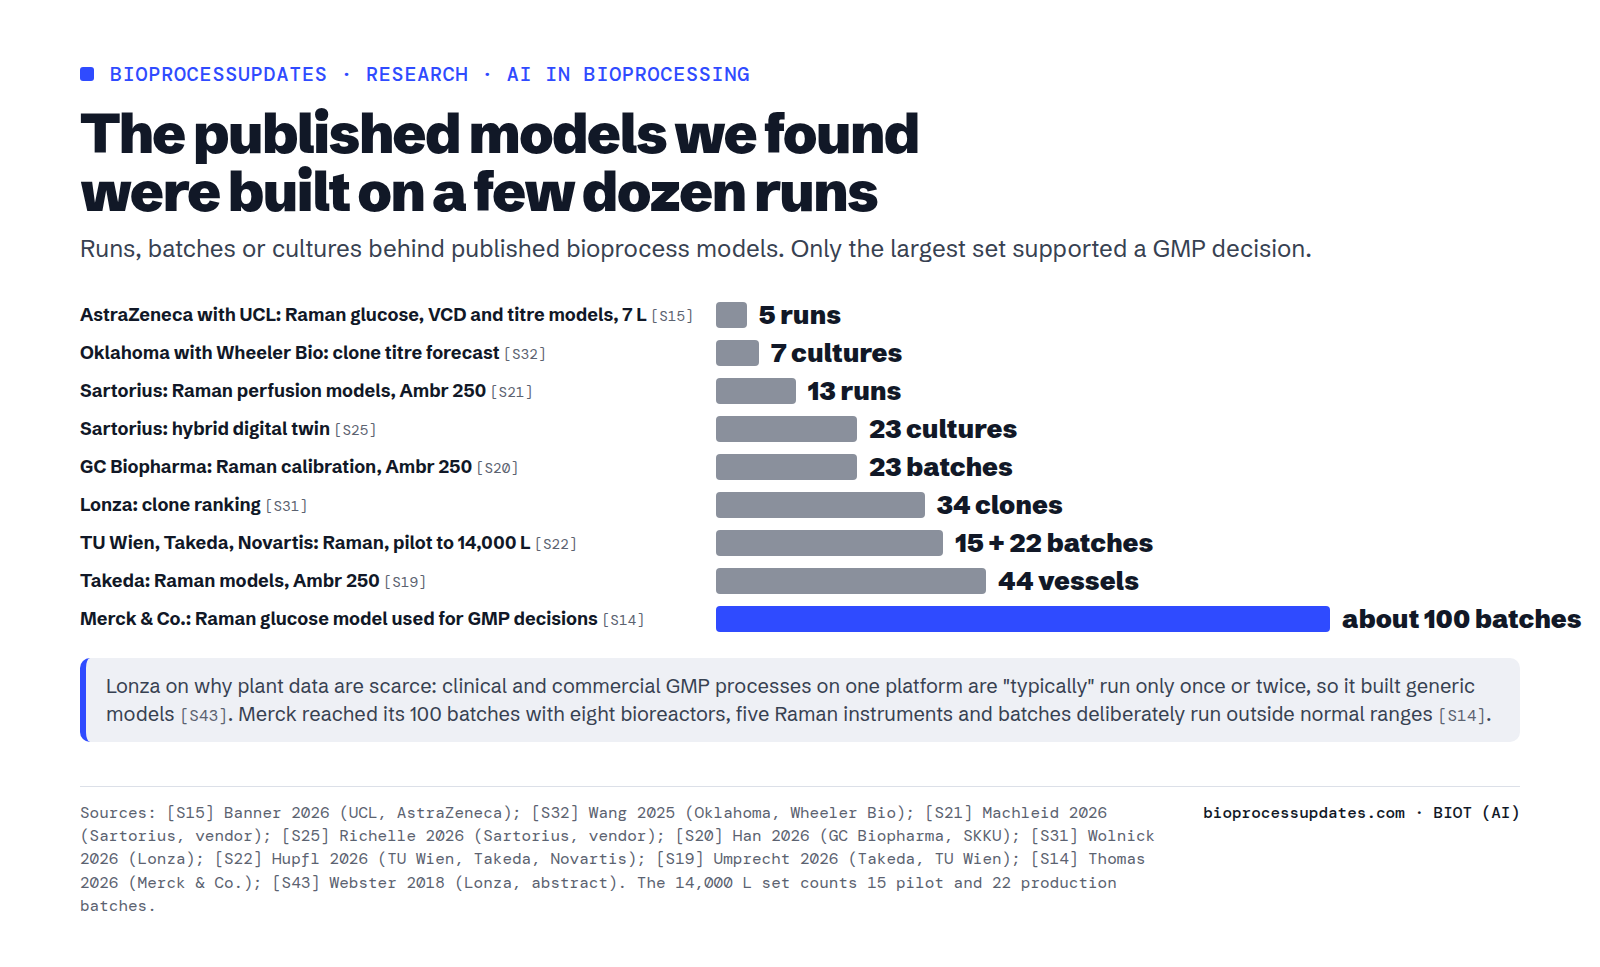
Las plantas generan pocos de los ensayos que necesita un modelo. Lonza señala que los procesos GMP clínicos y comerciales sobre una plataforma común suelen ejecutarse solo una o dos veces, y por eso desarrolló modelos genéricos que no dependen de la línea celular S43. ICH Q14 admite que es difícil conseguir suficiente variabilidad a escala comercial y que a menudo se recurre a muestras de laboratorio y de piloto, pero sigue recomendando incluir muestras a escala comercial S02. Takeda califica de «muy costoso en recursos» recalibrar con cada cambio de proceso S19. Un taller del sector organizado por NIIMBL con más de 130 participantes concluye que una recogida de datos limitada puede retrasar años el momento en que los algoritmos trabajen con datos de producción, y que los datos aislados en silos y sin estandarizar impiden a las empresas aprovechar los suyos propios S34.
Merck muestra lo que costó superar el listón. La compañía reunió unos cien lotes de fermentación de distintos serotipos, ocho biorreactores y cinco equipos Raman, a escala de laboratorio y comercial S14, y llevó lotes a propósito fuera de los rangos normales de pH, temperatura y agitación, con varios lotes de materia prima, para que el modelo aprendiera lo que se iba a encontrar en planta S14.
Tampoco la referencia es perfecta. Un soft sensor se juzga frente a un método de laboratorio, y Sartorius cifra en torno al 10 % el error de los recuentos de células viables con los métodos offline habituales S17. Un modelo no puede parecer mejor que la medida con la que se compara.
Dónde fallan los modelos
Un modelo aprende las condiciones con las que se entrenó. Si cambian la escala, la línea celular, el equipo o las materias primas, puede alejarse de la realidad, a veces sin avisar.
- Escala. En un estudio de Gedeon Richter y la Budapest University of Technology and Economics, varios modelos de glucosa por infrarrojo cercano (NIR) entrenados a una sola escala predijeron cinco ensayos de 5000 L. El error (raíz del error cuadrático medio de predicción, RMSEP: el error típico en ensayos que el modelo nunca había visto) fue de 14,95 mM para un modelo de matraz agitado, 5,31 mM para uno de 20 L y 4,18 mM para uno entrenado con datos de 20 L más 100 L S18. Según nuestro cálculo, el modelo de matraz fue 3,6 veces peor; en gramos, 2,7 frente a 0,75 g/L. En la calibración, ese mismo modelo había dado buena impresión S18.
- Línea celular. En Takeda, un modelo Raman de título tuvo un RMSEP de 0,125 g/L en la línea celular con la que se construyó y de 0,776 g/L en una segunda línea, unas seis veces más; la glucosa y el lactato se transfirieron bien S19. Al añadir a la calibración muestras enriquecidas con anticuerpo purificado, el error en la nueva línea bajó al 7,97 % del rango, frente al 23,93 % anterior S19.
- De piloto a producción. TU Wien, Takeda y Novartis llevaron modelos Raman de glucosa de un proceso con E. coli desde recipientes piloto de 50 y 150 L hasta 14.000 L. En muestras con glucosa alta, los modelos entrenados solo con datos piloto se desviaron más del 50 % de la media; dos métodos de alineamiento que usaban espectros de producción sin etiquetar lo redujeron al 15,9 % y al 17,3 % S22. El mismo artículo observó que el alineamiento no aportaba nada, o empeoraba el resultado, cuando la variabilidad dentro de una misma escala era alta S22.
- Equipo y tiempo. Johnson & Johnson comprobó que los modelos Raman son específicos del fabricante del equipo S45. Amgen afirma que los modelos Raman calibrados solo son fiables en sus condiciones de calibración y que suelen degradarse con los cambios de receta, la variabilidad de las materias primas y la deriva S42. Ambos se leyeron en resumen.
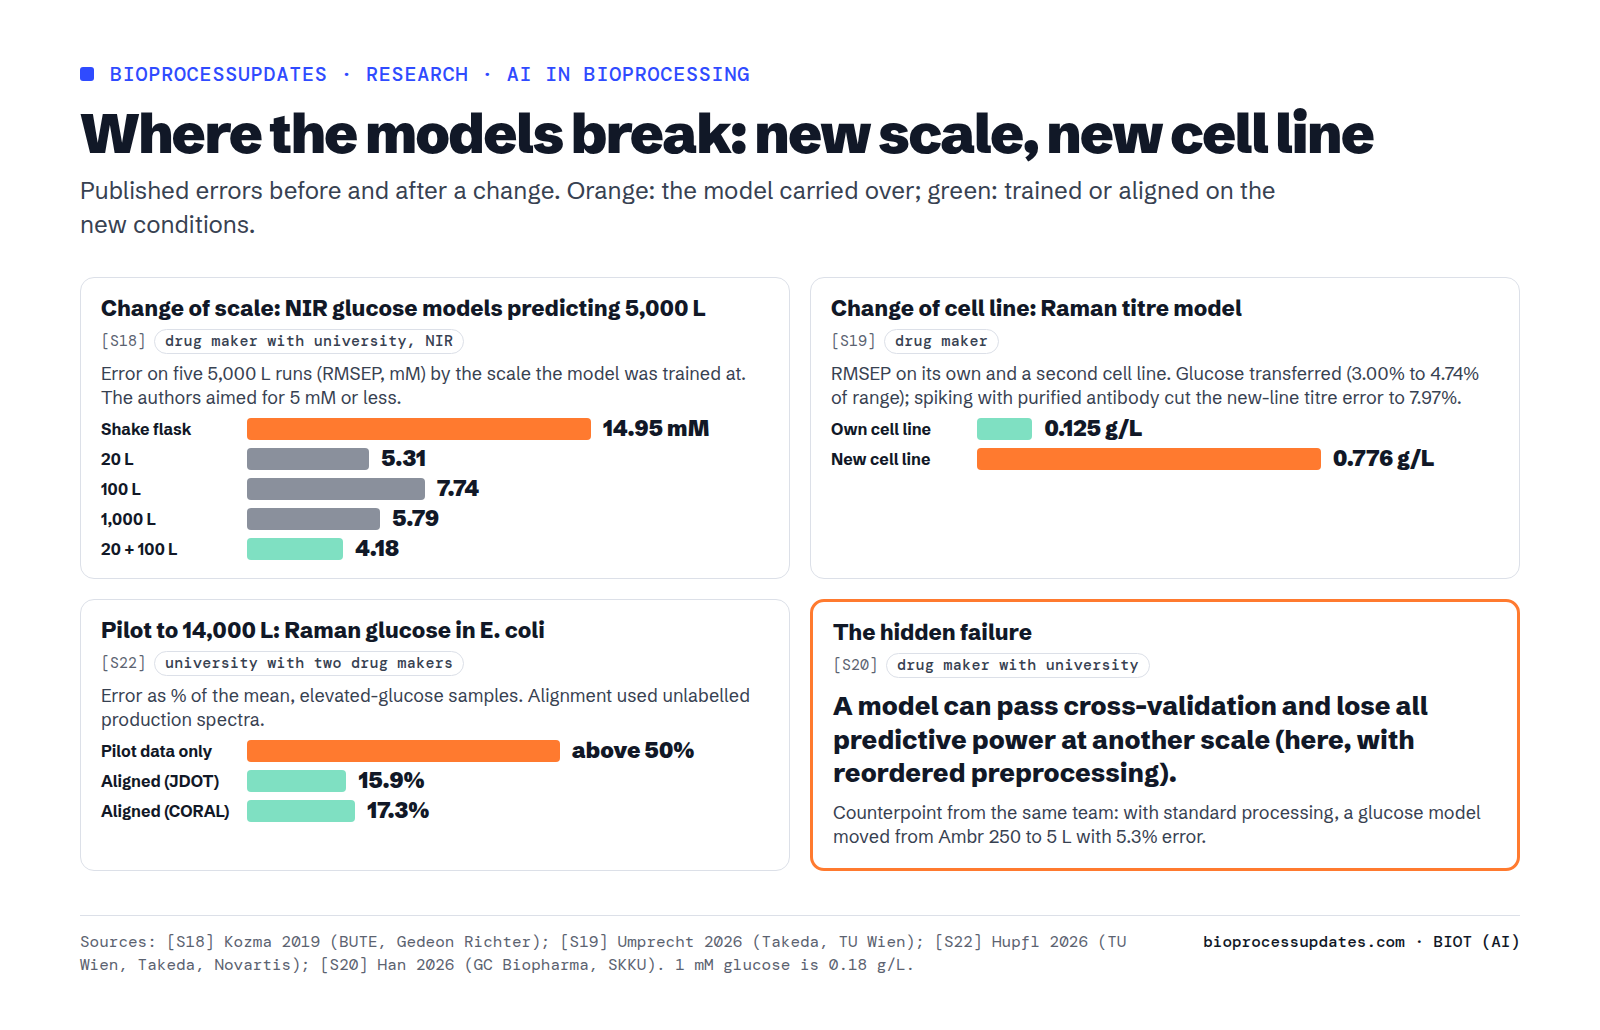
El fallo puede pasar inadvertido. En GC Biopharma, un modelo en el que los pasos de preprocesado de datos se aplicaron en otro orden mantuvo una buena puntuación en validación cruzada, pero perdió toda capacidad predictiva con datos de otra escala S20. El mismo equipo pasó un modelo de glucosa de minibiorreactores Ambr 250 a 5 L con un error del 5,3 % y sin recalibrar S20, y Takeda resume trabajos anteriores en los que los modelos de glucosa se transfirieron entre escalas sin datos de fabricación, mientras que los de densidad celular no S19. La glucosa es el caso fácil; no siempre hay fallo.
Pruébelo: el modelo que no sobrevive al escalado
El simulador muestra cómo ocurre. Genera espectros Raman sintéticos de un cultivo fed-batch, entrena un modelo de glucosa (una regresión por mínimos cuadrados parciales, el método habitual para espectros) con tres lotes de 2 L y después lo aplica, sin tocarlo, a 200 L y a 2000 L. A esas escalas cambian la sonda, la densidad celular, el perfil de lactato, la consigna de glucosa y el lote de medio, que es fluorescente. Las fuentes citadas más arriba describen estas causas de fallo; su magnitud aquí es inventada. Es un modelo didáctico e ilustrativo. No está validado frente a ningún proceso publicado, porque ninguna de las fuentes que leímos da los dos errores, antes y después de recalibrar, de un modelo Raman de glucosa que pasa a 2000 L.
En el simulador, el modelo de 2 L comete un error de 0,24 g/L en un lote nuevo de 2 L. A 2000 L, el mismo modelo yerra en 1,51 g/L y de media lee 1,37 g/L de más. Un controlador de alimentación que se fiara de él alimentaría de menos. Basta con añadir un lote de 2000 L a los datos de entrenamiento para que el error vuelva a 0,30 g/L. La tendencia coincide con los casos publicados. Janssen informó de que añadir un único lote a escala de fabricación mejoró en un 77,5 % la predicción de la glicosilación a 2000 L S39, y Merck construyó su modelo con datos a escala comercial ya incluidos S14.
Qué resultados se ven en planta
Buscamos mejoras que los fabricantes de medicamentos hayan publicado sobre sus propios procesos y etiquetamos cada una según dónde se midió.
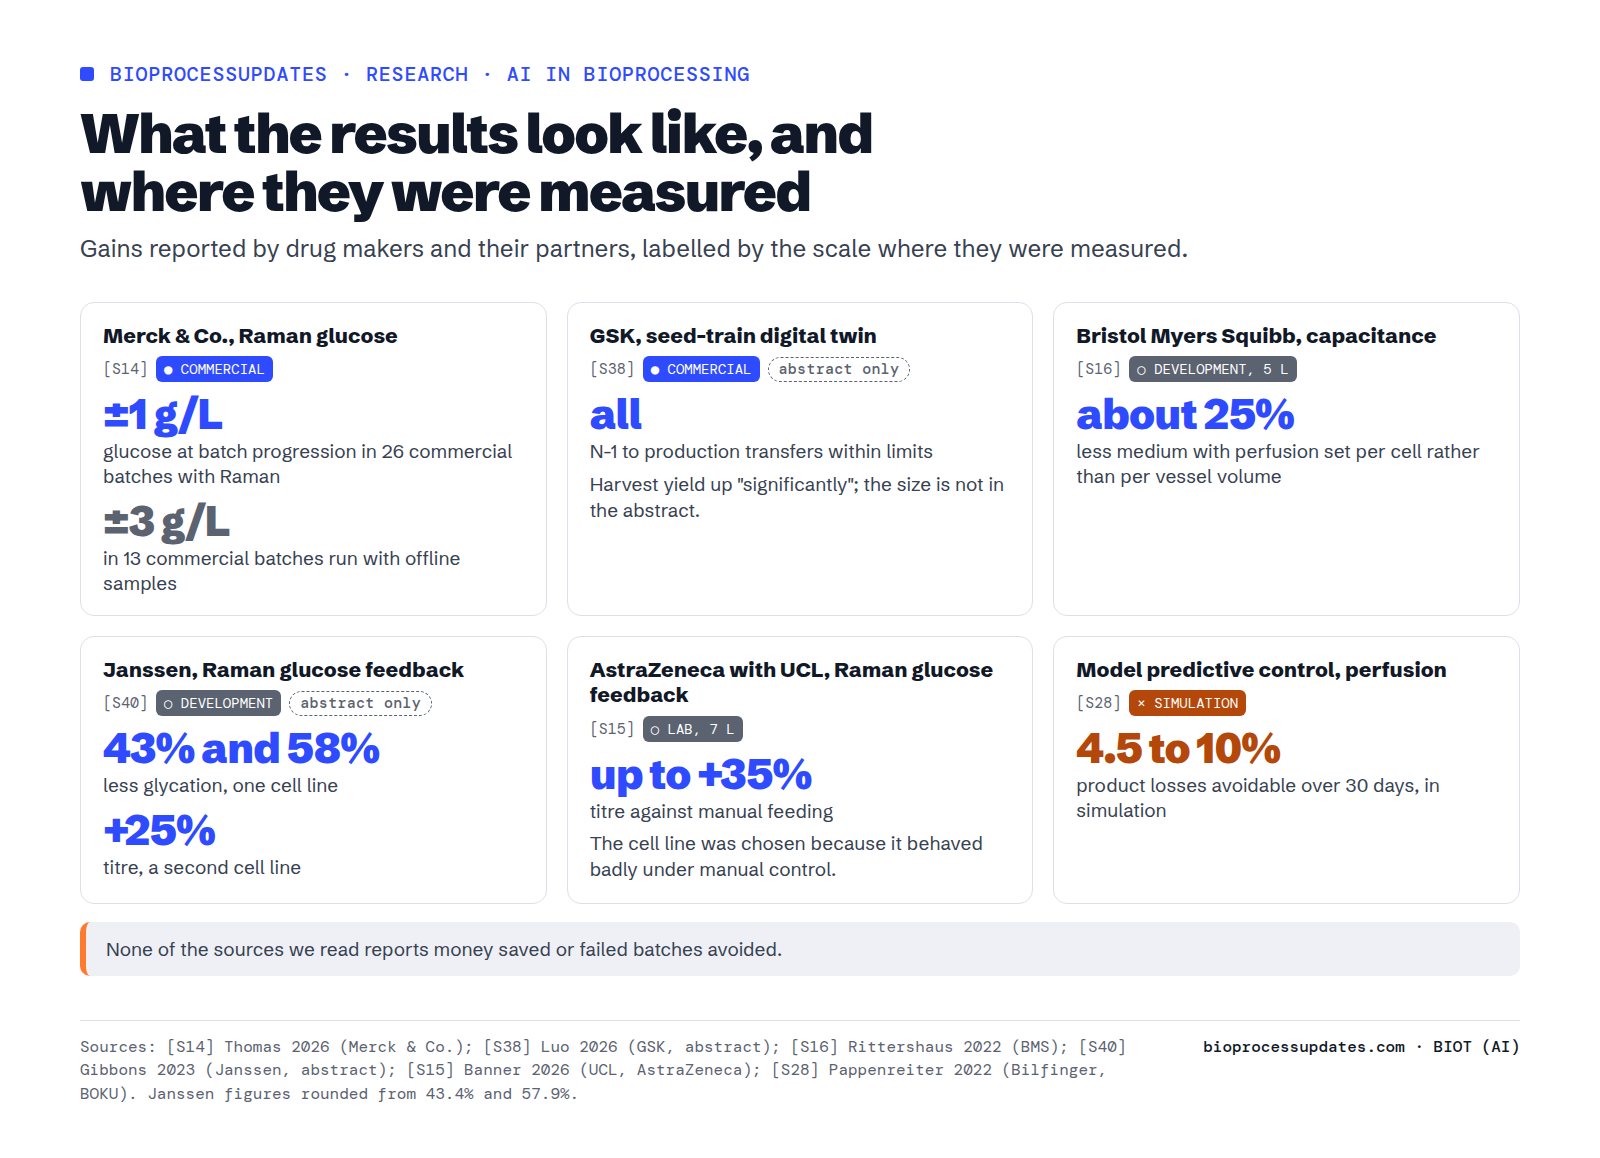
- Merck, comercial. Con el método Raman, los 26 lotes comerciales pasaron a la fase siguiente a más o menos 1 g/L del objetivo de glucosa. Los 13 lotes comerciales que se hicieron con el método offline quedaron a más o menos 3 g/L S14. Merck menciona un menor coste de operación y una manipulación más segura (sin muestras de nivel de bioseguridad 2 que manejar), pero no da ninguna cifra de coste S14.
- GSK, comercial. El gemelo del tren de inóculo (seed train) dio una mejora de rendimiento estadísticamente significativa. El resumen no indica su magnitud S38.
- BMS, desarrollo. En ensayos de 5 L, fijar la tasa de perfusión por célula a partir de la sonda de capacitancia, y no por volumen de reactor, redujo el consumo de medio en torno a un 25 % sin perjudicar el crecimiento S16.
- Janssen, desarrollo. La retroalimentación de glucosa con Raman redujo la glicación un 43,4 % y un 57,9 % en lotes de una línea celular y elevó el título un 25 % en otra S40 (resumen).
- AstraZeneca con UCL, laboratorio. A 7 L, el título fue hasta un 35 % mayor que con alimentación manual S15. La línea celular se eligió porque se comportaba mal con control manual, lo que favorece una mejora grande S15.
- Simulación. Según una simulación de Monte Carlo de Bilfinger y BOKU, el control predictivo por modelo podría evitar entre el 4,5 y el 10 % de las pérdidas de producto en 30 días de perfusión S28.
Las cifras de los proveedores piden la misma cautela. En un estudio de Sartorius, el control de la purga (bleed) basado en Raman mantuvo la densidad celular con un error absoluto medio de 5,97 millones de células/mL. En un ensayo paralelo controlado con un contador celular, el error fue de 3,90 millones S21. Sartorius considera que ambos resultados son comparables. Con estas cifras, y con un solo ensayo de cada tipo, la sonda lo hizo peor que el instrumento al que vendría a sustituir. Una revisión de Bayer cita una estimación de una consultora de entre 60 y 110 mil millones de dólares al año para la IA generativa en farma S33. Es una estimación, no un resultado de planta.
Medios, proceso y clones: menos experimentos con pocos datos
La optimización bayesiana elige cada experimento según lo que enseñaron los anteriores. En el MIT optimizó las fuentes de carbono de la levadura K. phaffii en 90 experimentos repartidos en 7 rondas. Son entre 2,5 y 3 veces menos, aproximadamente, que los que se calcularon para un diseño de experimentos (DoE) estándar. El DoE solo se estimó, no se llegó a ejecutar S29. Según una revisión de 2025 de la TU Wien, la mayoría de los estudios que comparan ambos métodos obtienen menos experimentos y mejores resultados con la optimización bayesiana. Sin embargo, la revisión solo encuentra 22 registros en Scopus sobre optimización bayesiana en bioprocesos. También señala que el rendimiento suele caer por encima de unas 20 variables y que el método exige conocimientos de machine learning que el DoE no requiere S30.
En clones, Lonza entrenó modelos con datos rutinarios de clones para ordenarlos de cara a un proceso intensificado. En uno de los dos productos reservados para la prueba, el clon mejor clasificado dio un 68,5 % más de título que el clon elegido por el método tradicional. En el otro, el título fue ligeramente inferior S31. Lonza considera que sus 34 clones son muchos para desarrollo de procesos, pero pocos para machine learning S31. Sus datos muestran además por qué los cribados engañan: el mejor clon del cribado estándar fue el de menor título de todos en el proceso intensificado S31.
Las normas: qué exigen los reguladores a un modelo
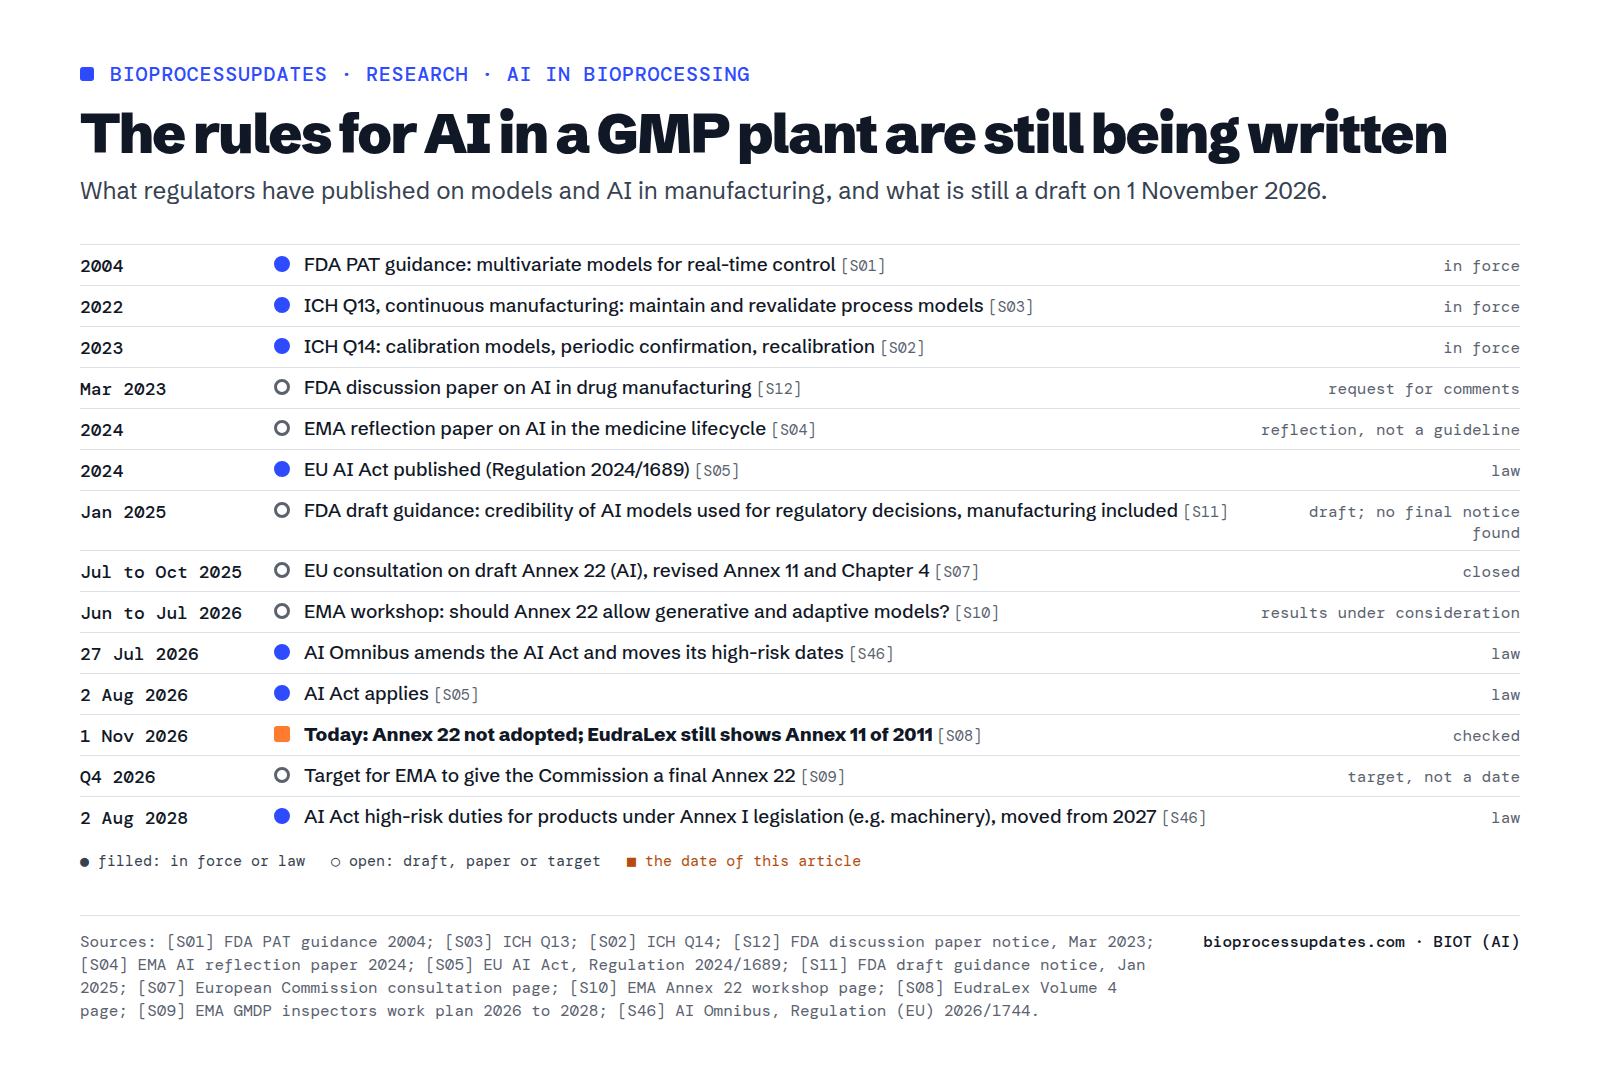
Anexo 22 de las GMP de la UE. El primer texto GMP escrito para la IA lo redactó el grupo de trabajo de inspectores de la Agencia Europea de Medicamentos (EMA) junto con el Pharmaceutical Inspection Co-operation Scheme (PIC/S) S07. Estuvo en consulta pública del 7 de julio al 7 de octubre de 2025 S07. Se aplica a los modelos de IA en aplicaciones GMP críticas, las que afectan directamente a la seguridad del paciente, la calidad del producto o la integridad de los datos S06. En esos usos, el borrador solo admite modelos estáticos, que no siguen aprendiendo mientras se usan, y deterministas, que dan la misma salida ante la misma entrada. No deberían usarse ni la IA generativa ni los LLMs. En los usos no críticos, revisar la salida sigue siendo responsabilidad de personal debidamente cualificado y formado S06. Los criterios de aceptación de un modelo tienen que ser como mínimo tan exigentes como el rendimiento del proceso al que sustituye S06. Los datos de prueba no pueden haberse usado nunca en el entrenamiento y deben estar protegidos con control de acceso y audit trail S06. Además, hay que vigilar la deriva de los datos de entrada S06.
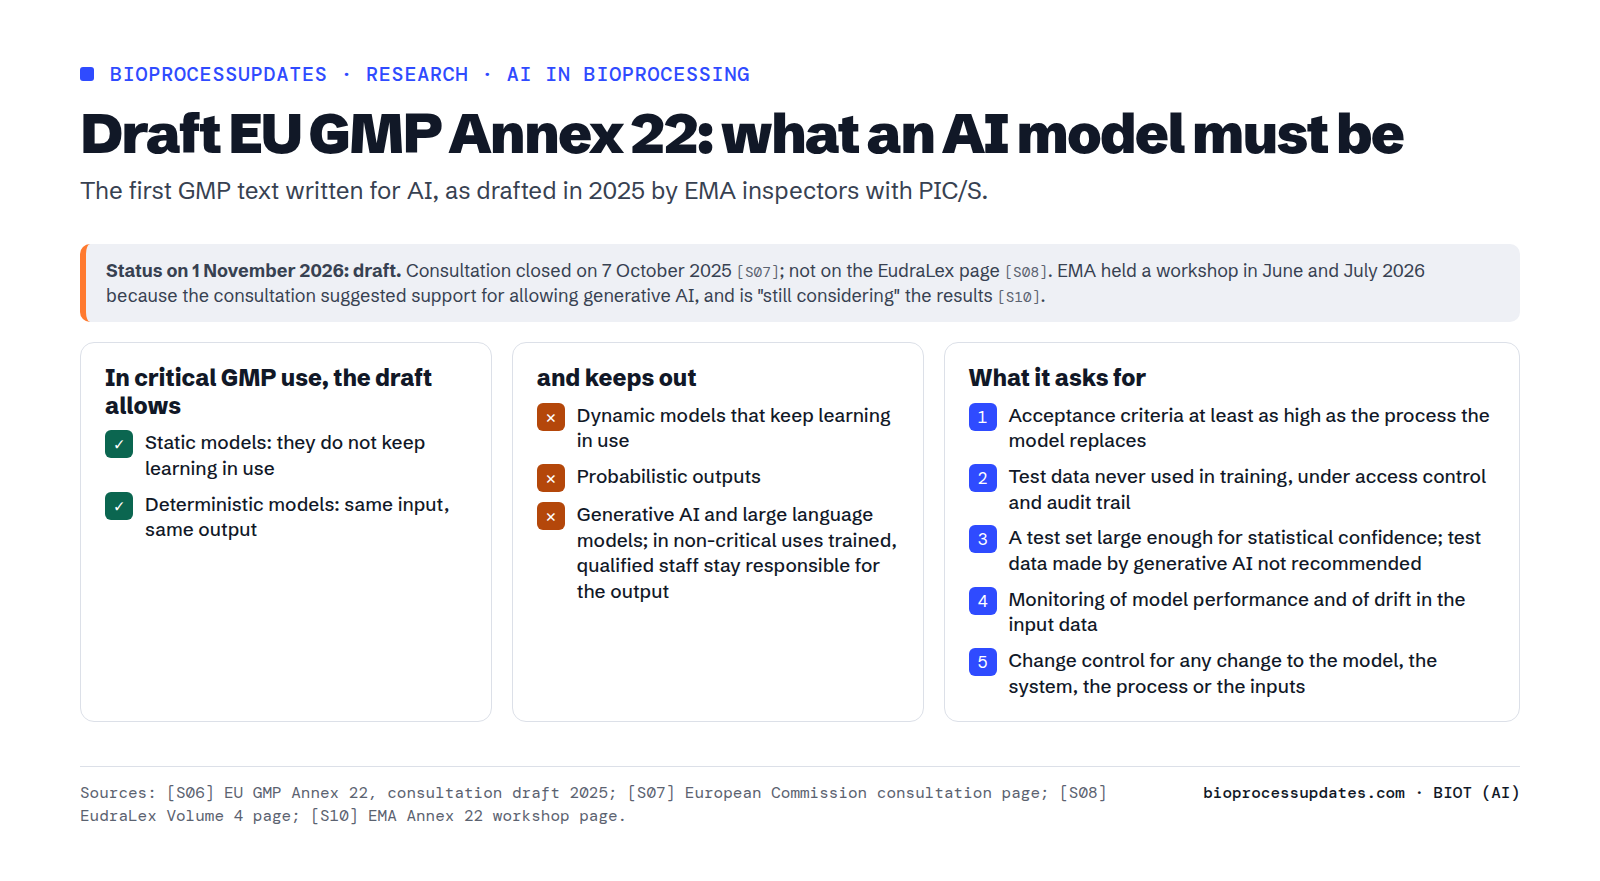
A 1 de noviembre de 2026, el anexo 22 no se ha adoptado. La página del volumen 4 de EudraLex sigue recogiendo el anexo 11 y el capítulo 4 de enero de 2011, y no incluye ningún anexo 22 S08. El plan de trabajo de los inspectores de la EMA se marca el cuarto trimestre de 2026 para entregar a la Comisión un texto final S09. Es un objetivo, no una fecha de adopción. La EMA celebró un taller el 30 de junio y el 1 de julio de 2026 porque la consulta apuntaba a que había apoyo para permitir la IA generativa en fabricación. La agencia dice que aún está valorando los resultados S10, así que el alcance restrictivo del borrador podría cambiar. Nuestro artículo sobre IA en GMP repasa el borrador del anexo 22 requisito por requisito. También trata el anexo 11 y el capítulo 4 revisados, el borrador de la FDA y cómo se valida hoy un modelo que aprende.
Ley de IA de la UE. Un sistema de IA es de alto riesgo según el Reglamento 2024/1689 por dos vías. La primera es ser componente de seguridad de un producto regulado por la legislación de la UE recogida en su anexo I que requiera evaluación de la conformidad por terceros. La segunda es figurar entre los usos que enumera el anexo III S05. El anexo III recoge ámbitos como la biometría, las infraestructuras críticas, la educación, el empleo y la aplicación de la ley. La fabricación de medicamentos no está entre ellos S05. Esta es nuestra lectura, no asesoramiento jurídico: un modelo de proceso en una planta farmacéutica no es un uso del anexo III, pero un componente de seguridad con IA en una máquina podría caer bajo el anexo I. El reglamento se aplica desde el 2 de agosto de 2026 S05. En julio de 2026 se adoptó una modificación, el AI Omnibus, que aplazó la vía del anexo I al 2 de agosto de 2028 y los usos del anexo III al 2 de diciembre de 2027 S46.
FDA. En enero de 2025, la FDA publicó un borrador de guía con un marco basado en el riesgo para establecer la credibilidad de un modelo de IA en un contexto de uso concreto. El marco cubre la fabricación junto con otros usos que respaldan decisiones regulatorias S11. No encontramos en el Federal Register ningún aviso de una versión final. La propia guía devolvía un error a nuestro servidor, así que la leímos a través de su aviso. Su documento de debate de 2023 sobre IA en la fabricación de medicamentos era una solicitud de comentarios, no una guía S12.
Lo que ya está en vigor. La guía de la FDA de 2004 sobre tecnología analítica de procesos (PAT) ya decía que los métodos multivariantes a menudo son necesarios para el control en tiempo real S01. ICH Q14 pide confirmar los modelos de calibración de forma periódica y también ante eventos como cambios en el proceso o el mantenimiento del instrumento. Además, admite recalibraciones que incorporen datos nuevos y descarten los antiguos S02. ICH Q13 exige mantener el modelo de forma continua durante la fabricación comercial. Cuando cambian las entradas o los parámetros, y según el tipo de cambio, también pide volver a desarrollarlo y revalidarlo S03. El documento de reflexión de la EMA de 2024 pide vigilar el rendimiento con umbrales que detecten pronto la deriva S04. Un soft sensor validado no necesita ninguna norma nueva, mientras que un modelo adaptativo o generativo en un uso crítico todavía no tiene ninguna.
Qué significa para una planta
- Empezar por una sola decisión. Conviene elegir un soft sensor que sustituya a una medida offline que ya se use para tomar una decisión y fijar el criterio de aceptación antes de validar. Merck fijó un RMSEP igual o inferior a 1 g/L en su rango de decisión, de 0 a 10 g/L. También comprobó que, frente al analizador offline, el momento de la decisión se movía menos de 20 minutos S14. El borrador del anexo 22 pide lo mismo: no ser peor que el proceso al que sustituye S06.
- Primero, la glucosa. En las fuentes, los modelos de glucosa se transfirieron entre líneas celulares y escalas mejor que los de título o densidad celular S19 S20.
- Buscar variedad, no volumen. Merck hizo a propósito lotes fuera de los rangos normales S14. Los datos de 20 L y 100 L combinados predijeron mejor la escala de 5000 L que los de cualquier escala por separado S18. En Janssen, un solo lote de fabricación mejoró los modelos S39.
- Hay calibraciones más baratas. IRUBIS (el fabricante del analizador) y Amgen calibraron un analizador de infrarrojo medio con un solo punto. Con él lograron un error de glucosa de 0,29 g/L en 22 ensayos de perfusión, en línea con los modelos convencionales construidos con 206 muestras (0,41 g/L) S23. El Imperial College adaptó un modelo mecanicista a una nueva línea celular o a una nueva escala con un único conjunto de datos del sistema nuevo S24.
- Prever el día en que el modelo falle. Q14 pide comprobaciones periódicas y también ante eventos concretos S02. Tras el lanzamiento, Merck volvió a verificar tres lotes comerciales y obtuvo un RMSEP de 0,94 g/L, dentro de su criterio de 1 g/L S14. A partir de ensayos controlados con la sonda, BMS elaboró un calendario fijo para las plantas que no la tienen o para cuando la sonda falle S16. En los ensayos de laboratorio de AstraZeneca, un pequeño ordenador se sobrecalentó y el lazo de control se cayó durante parte de los días 10 a 12 S15.
- Mirar de dónde viene el dato. Antes de creerse una afirmación, conviene preguntar quién la publica, a qué escala y con cuántos lotes. En este campo, la respuesta suele ser un proveedor, a escala de banco o de minibiorreactor, con un puñado de ensayos.
La serie IA en la planta
Este artículo de referencia es el mapa de la serie. Ya se han publicado tres entregas. PAT en la práctica explica qué sondas y modelos funcionan y por dónde empezar. Diseño de cepas con machine learning, explicado cuenta qué es ML4SD, qué mide de verdad el ahorro que se publica y qué se ha demostrado en laboratorio. IA en GMP trata el borrador del anexo 22, el borrador de guía de la FDA y cómo se valida hoy un modelo que aprende. Próximamente: gemelos digitales sin exageraciones, modelos híbridos, optimización bayesiana frente a diseño de experimentos, modelos de lenguaje en calidad y control Raman en lazo cerrado. Enlazaremos aquí cada entrega cuando se publique. Para el escalado en sí, véase Escalado de biorreactores, explicado.
Preguntas
¿Qué es la IA en bioprocesos?
Sobre todo, modelos que aprenden de los datos del proceso. Hay soft sensors que estiman la glucosa o la densidad celular a partir de la señal de una sonda S03 y monitorización multivariante que detecta lotes anómalos S37. También hay gemelos digitales S38 y herramientas para optimizar medios o clones S29 S31. En las fuentes que leímos, los soft sensors y la monitorización multivariante ya tienen uso GMP o comercial, y un gemelo digital asesora a los operarios en producción comercial. El resto sigue en desarrollo.
¿Cómo se usa hoy la IA en la fabricación farmacéutica?
Las fuentes sobre biológicos que leímos describen tres usos. El primero son los soft sensors Raman y de capacitancia que disparan o ajustan una etapa S14 S41. Los otros dos son la monitorización multivariante S37 y un gemelo digital del tren de inóculo que asesora a los operarios S38. Ninguna fuente mostró en planta el control en lazo cerrado ni los modelos de lenguaje.
¿Permite la FDA la IA en la fabricación de medicamentos?
No hay ninguna prohibición. La guía PAT de 2004 ya respalda los modelos multivariantes para el control en tiempo real S01. Un borrador de guía de enero de 2025 propone un marco de credibilidad basado en el riesgo para los modelos de IA que respaldan decisiones regulatorias, también en fabricación S11. No encontramos ninguna versión final.
¿Qué es el anexo 22 de las GMP de la UE sobre inteligencia artificial?
Es un nuevo anexo de la guía de GMP de la UE para modelos de IA en usos GMP críticos, redactado en 2025 S06 S07. El borrador admite modelos estáticos y deterministas y deja la IA generativa y los LLMs fuera de los usos críticos S06. A 1 de noviembre de 2026 no se ha adoptado S08 S10.
¿Qué es un soft sensor en un bioproceso?
Es un modelo que ocupa el lugar de una medida física y estima una variable a partir de datos medidos del proceso S03. Por ejemplo, estima la glucosa a partir de un espectro Raman S14 o las células vivas a partir de una sonda de capacitancia S16.
¿Qué es un gemelo digital en la fabricación farmacéutica?
Es un modelo del proceso que las mediciones mantienen sincronizado con el proceso real. El caso comercial que encontramos es el gemelo del tren de inóculo de GSK, que indica a los operarios cuándo tomar muestras S38. Los gemelos predictivos del cultivo completo siguen en desarrollo S25 S26.
¿Puede el machine learning optimizar un bioproceso?
En desarrollo, sí. En un estudio académico, la optimización bayesiana necesitó entre 2,5 y 3 veces menos experimentos que un DoE calculado S29. En Lonza, el machine learning eligió un clon mejor en uno de los dos productos S31. Los conjuntos de datos son pequeños S30 S31.
¿Puede la IA revisar registros de lote?
No encontramos ninguna fuente primaria con resultados. Una revisión de Bayer lo menciona como uso posible. También advierte de que los LLMs pueden alucinar, por lo que los expertos deben revisar lo que producen S33. El borrador del anexo 22 deja los LLMs fuera de los usos GMP críticos S06.
Lo que no pudimos verificar
- Un caso publicado de glucosa por Raman que dé los dos errores, antes y después de recalibrar, al pasar un modelo a pequeña escala a escala de producción. Por eso el simulador es ilustrativo.
- El texto definitivo de la guía de la FDA de enero de 2025, si existe: nuestro servidor no pudo abrir fda.gov y en el Federal Register solo figura el borrador.
- Los borradores revisados del Anexo 11 y del Capítulo 4, GAMP 5 y la guía de ISPE sobre IA, y el informe del taller de la EMA de junio de 2026.
- Las directrices de la Comisión sobre la clasificación de alto riesgo según la Ley de IA (AI Act).
- La magnitud de la mejora de rendimiento de GSK, las tasas de detección de Genentech y los artículos completos de varios casos de empresa (Biogen, Janssen, Amgen, modelos genéricos de Lonza), de los que solo leímos el resumen.
- Cualquier dato de planta sobre mantenimiento predictivo, sobre modelos de lenguaje en calidad o sobre el dinero que ahorra la IA en una planta de bioprocesos.
Fuentes
- S01 U.S. Food and Drug Administration (CDER, CVM, ORA), Guidance for Industry. PAT, A Framework for Innovative Pharmaceutical Development, Manufacturing, and Quality Assurance. Guía de la FDA para la industria, septiembre de 2004, 2004 (documento regulatorio). Publicado antes de 2015.
- S02 International Council for Harmonisation (ICH) Expert Working Group, ICH Q14 Analytical Procedure Development. Guía armonizada ICH, adoptada el 1 de noviembre de 2023, 2023 (documento regulatorio).
- S03 International Council for Harmonisation (ICH) Expert Working Group, ICH Q13 Continuous Manufacturing of Drug Substances and Drug Products. Guía armonizada ICH, adoptada el 16 de noviembre de 2022, 2022 (documento regulatorio).
- S04 European Medicines Agency, CHMP y CVMP, Reflection paper on the use of Artificial Intelligence (AI) in the medicinal product lifecycle, EMA/CHMP/CVMP/83833/2023. Documento de reflexión de la EMA, versión final del 9 de septiembre de 2024, 2024 (documento regulatorio).
- S05 European Parliament and Council of the European Union, Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act). Official Journal of the European Union L, 12.7.2024, 2024 (documento regulatorio).
- S06 European Commission; redactado por el EMA GMDP Inspectors Working Group con PIC/S, EudraLex Volume 4, Annex 22: Artificial Intelligence (draft for stakeholder consultation). European Commission, DG SANTE, documento de consulta (julio de 2025), 2025 (documento regulatorio).
- S07 European Commission, DG SANTE, Stakeholders’ consultation on EudraLex Volume 4: Chapter 4, Annex 11 and new Annex 22. Página de consulta de health.ec.europa.eu, 2025 (documento regulatorio).
- S08 European Commission, DG SANTE, EudraLex Volume 4: Good Manufacturing Practice guidelines (página índice). health.ec.europa.eu, 2026 (documento regulatorio).
- S09 European Medicines Agency, GMDP Inspectors Working Group, The 3-year work plan for the GMDP Inspectors Working Group, January 2026 to December 2028. Plan de trabajo de la EMA, 2026 (documento regulatorio).
- S10 European Medicines Agency, Good manufacturing practice: Multistakeholder workshop on expert contributions to artificial intelligence guidance development (Annex 22). Página del evento de la EMA (taller del 30 de junio al 1 de julio de 2026), 2026 (documento regulatorio).
- S11 US Food and Drug Administration, Considerations for the Use of Artificial Intelligence To Support Regulatory Decision-Making for Drug and Biological Products; Draft Guidance for Industry; Availability (aviso del Federal Register 2024-31542). Federal Register, 7 de enero de 2025, 2025 (documento regulatorio).
- S12 US Food and Drug Administration, Discussion Paper: Artificial Intelligence in Drug Manufacturing; Notice; Request for Information and Comments (aviso del Federal Register 2023-04206). Federal Register, 1 de marzo de 2023, 2023 (documento regulatorio).
- S14 Thomas GP et al., In-line Raman spectroscopy real-time glucose prediction method for commercial pneumococcal vaccine drug substance fermentation manufacturing process control. Biotechnology Progress, 2026. Afiliaciones: Merck & Co. (desarrollo de procesos, analítica y Vaccine Drug Substance Commercialization de MRL). Empresa biofarmacéutica que informa de su propio uso comercial en GMP. Hardware Raman de Endress+Hauser, software SIMCA de Sartorius; ningún autor de proveedor.
- S15 Banner M et al., Advanced glucose control strategies leveraging Raman spectroscopy for optimized mammalian cell culture manufacturing. Biotechnology Progress, 2026. Afiliaciones: University College London (académica) con AstraZeneca R&D (empresa biofarmacéutica); doctorado industrial financiado por BBSRC y AstraZeneca. Ningún autor de proveedor.
- S16 Rittershaus ESC et al., N-1 Perfusion Platform Development Using a Capacitance Probe for Biomanufacturing. Bioengineering (Basel) 9:128, 2022. Afiliaciones: Bristol Myers Squibb (empresa biofarmacéutica). Sonda: Hamilton Incyte.
- S17 Metze S et al., Monitoring online biomass with a capacitance sensor during scale-up of industrially relevant CHO cell culture fed-batch processes in single-use bioreactors. Bioprocess Biosyst Eng 43:193-205, 2020 (firmado por el proveedor). Afiliaciones: Sartorius Stedim Biotech (proveedor de los biorreactores single-use y de la integración del sensor de capacitancia). Artículo revisado por pares firmado por el proveedor.
- S18 Kozma B et al., On-line glucose monitoring by near infrared spectroscopy during the scale up steps of mammalian cell cultivation process development. Bioprocess Biosyst Eng 42:921-932, 2019. Afiliaciones: Budapest University of Technology and Economics (académica) con Gedeon Richter (empresa biofarmacéutica, planta de producción donde se hicieron los lotes).
- S19 Umprecht A et al., Rapid development of a transferable Raman model using high-throughput cell culture for monitoring monoclonal antibody titer. Biotechnol Prog e88506, 2026. Afiliaciones: Takeda (Baxalta Innovations, Viena; Takeda Lexington), empresa biofarmacéutica, con TU Wien (académica). Equipos: Sartorius Ambr 250 y BioPAT Spectro.
- S20 Han SH et al., Variable-specific preprocessing enables cross-scale transferable Raman models from high-throughput bioreactor data. Bioresour Bioprocess 13:122, 2026. Afiliaciones: GC Biopharma (empresa biofarmacéutica, MSAT) con Sungkyunkwan University (académica).
- S21 Machleid R et al., Advancing Raman Calibration: Automated Data Generation, Monitoring, and Control in Multi-Parallel Perfusion Mini Bioreactors. Biotechnol J 21:e70208, 2026 (firmado por el proveedor). Afiliaciones: Sartorius Stedim Biotech, Sartorius Stedim Cellca, Sartorius Stedim Data Analytics (proveedor del sistema Ambr, la celda de flujo Raman y el software SIMCA) con Umea University. Firmado por el proveedor.
- S22 Hupfl B et al., Limits and benefits of unsupervised transfer learning for Raman spectroscopy-based bioprocess monitoring. Bioprocess and Biosystems Engineering, 2026. Afiliaciones: TU Wien (académica) con Baxalta Innovations (Takeda) y Novartis Pharmaceutical Manufacturing, Kundl (empresas biofarmacéuticas; datos de producción de Novartis). Ningún autor de proveedor.
- S23 Marienberg H et al., Automized inline monitoring in perfused mammalian cell culture by MIR spectroscopy without calibration model building. Eng Life Sci 24:e2300237, 2024 (con coautoría del proveedor). Afiliaciones: IRUBIS GmbH (proveedor del analizador MIR) con Amgen Research (empresa biofarmacéutica). Coautoría del proveedor.
- S24 Yu L et al., Model-Enabled Knowledge Transfer Across Cell Lines, Culture Scales and Conditions. Biotechnol Bioeng 123:2613-2628, 2026. Afiliaciones: Imperial College London (académica).
- S25 Richelle A et al., A Hybrid Modeling Framework for Predictive Digital Twins of CHO Cell Culture. Computational and Structural Biotechnology Journal, 2026 (documento de proveedor). Afiliaciones: Sartorius Corporate Research (proveedor de biorreactores y software de modelado). Firmado por el proveedor.
- S26 Satwekar A et al., Operationalizing digital twins in biomanufacturing through interoperable process analytical technology. Bioprocess and Biosystems Engineering, 2026. Afiliaciones: NIIMBL (instituto público-privado) con Merck Serono, Pfizer, NC State BTEC y NIST. Mezcla de industria, academia y administración.
- S27 Gadiyar CJ et al., Self-Driving Development of Perfusion Processes for Monoclonal Antibody Production. Biotechnology and Bioengineering, 2026 (con coautoría del proveedor). Afiliaciones: DataHow AG (proveedor del software) con Merck Serono (empresa biofarmacéutica) y TU Berlin (académica). Coautoría del proveedor.
- S28 Pappenreiter M et al., Model predictive control for steady-state performance in integrated continuous bioprocesses. Bioprocess and Biosystems Engineering, 2022. Afiliaciones: Bilfinger Life Science (empresa de ingeniería) con BOKU Vienna (académica).
- S29 Narayanan H et al., Accelerating cell culture media development using Bayesian optimization-based iterative experimental design. Nature Communications, 2025. Afiliaciones: MIT Koch Institute y Broad Institute (académicas).
- S30 Gisperg F et al., Bayesian Optimization in Bioprocess Engineering: Where Do We Stand Today?. Biotechnology and Bioengineering, 2025 (revisión). Afiliaciones: TU Wien y Christian Doppler Laboratory (académicas).
- S31 Wolnick N et al., Machine learning-assisted clone selection for intensified cell culture processes. Biotechnology Progress, 2026. Afiliaciones: Lonza R&D, Bend, Oregón (CDMO, plataforma y datos propios).
- S32 Wang P et al., Luedeking-Piret regression for multi-step-ahead forecasting and clone selection in monoclonal antibodies biomanufacturing. Communications Engineering, 2025. Afiliaciones: University of Oklahoma (académica) con Wheeler Bio (CDMO).
- S33 Panjwani S et al., Artificial intelligence and machine learning-assisted digital applications for biopharmaceutical manufacturing. Biotechnology Progress, 2026 (revisión). Afiliaciones: Bayer Pharmaceuticals, CMC & Technology, Berkeley (empresa biofarmacéutica). Revisión, sin datos nuevos.
- S34 Hart R et al., Industry-defined opportunities for advancing big data capabilities in biopharmaceutical manufacturing. Frontiers in Bioengineering and Biotechnology, 2026. Afiliaciones: NIIMBL con Nexight Group; síntesis de un taller con más de 130 participantes de la industria, la academia y la administración.
- S36 Mehdizadeh H et al., Generic Raman-based calibration models enabling real-time monitoring of cell culture bioreactors. Biotechnology Progress, 2015. Afiliaciones: Pfizer (empresa biofarmacéutica). Se leyó el resumen.
- S37 Sammaknejad N et al., A Scalable Deep Learning Approach for Real-Time Multivariate Monitoring of Biopharmaceutical Processes With No Prior Product-Specific History. Biotechnology and Bioengineering, 2025. Afiliaciones: equipos de fabricación, IT/OT y datos de Genentech (Roche) (empresa biofarmacéutica). Se leyó el resumen.
- S38 Luo Y et al., A Biomanufacturing Digital Twin for Consistent N-1 Seed Bioreactor Transfers for Commercial Monoclonal Antibody Production. Biotechnology and Bioengineering, 2026. Afiliaciones: GSK (Enterprise AI, MSAT, Drug Substance Development, Supply Chain Digital). Empresa biofarmacéutica. Se leyó el resumen.
- S39 Gibbons LA et al., Raman based chemometric model development for glycation and glycosylation real time monitoring in a manufacturing scale CHO cell bioreactor process. Biotechnol Prog 38:e3223, 2022. Afiliaciones: Janssen (Johnson & Johnson), empresa biofarmacéutica, con Munster Technological University. Se leyó el resumen.
- S40 Gibbons L et al., An assessment of the impact of Raman based glucose feedback control on CHO cell bioreactor process development. Biotechnol Prog 39:e3371, 2023. Afiliaciones: Janssen (Johnson & Johnson), empresa biofarmacéutica, con Munster Technological University. Se leyó el resumen.
- S41 Moore B et al., Case study: The characterization and implementation of dielectric spectroscopy (biocapacitance) for process control in a commercial GMP CHO manufacturing process. Biotechnol Prog 35:e2782, 2019. Afiliaciones: Biogen (empresa biofarmacéutica). Se leyó el resumen.
- S42 Tulsyan A et al., Automatic real-time calibration, assessment, and maintenance of generic Raman models for online monitoring of cell culture processes. Biotechnol Bioeng 117:406-416, 2020. Afiliaciones: Amgen (empresa biofarmacéutica). Se leyó el resumen.
- S43 Webster TA et al., Development of generic Raman models for a GS-KO CHO platform process. Biotechnol Prog 34:730-737, 2018. Afiliaciones: Lonza Biologics (CDMO, plataforma propia). Se leyó el resumen.
- S44 Shen Y et al., Machine Learning-Enhanced Generic Raman Model for Commercial-Scale Cell Culture Process Monitoring. Biotechnol J 21:e70309, 2026. Afiliaciones: BioRay Biopharmaceutical (empresa biofarmacéutica) con Zhejiang University. Se leyó el resumen.
- S45 Myers NM et al., Calibration Transfer Across Instrument Vendors for Bioprocess Raman Monitoring. AAPS J 28:5, 2025. Afiliaciones: Johnson & Johnson Innovative Medicine (empresa biofarmacéutica). Se leyó el resumen.
- S46 European Parliament and Council of the European Union, Regulation (EU) 2026/1744 amending Regulations (EU) 2024/1689, (EU) 2018/1139 and (EU) 2023/1230 (Digital Omnibus on AI). Official Journal of the European Union L, 24.7.2026, 2026 (documento regulatorio).